Beslutningsgrunnlag for kontroll i det digitale landskapet
Publisert 26. september 2026 · Ansvarlig redaktør: Terje Moy
Automatisering, syntetisk innholdsproduksjon og fragmenterte datakilder utfordrer etablerte kontrollrutiner i norske virksomheter. Informasjonsflyten preges av maskinskapte tekster, manipulerte eller helsyntetiske bildefiler samt uoversiktlige eierskaps- og tilstandsdata ved fysiske transaksjoner. Når skillet mellom autentiske observasjoner og algoritmiske konstruksjoner viskes ut, oppstår et akutt behov for presise analyseverktøy. Beslutningstakere må forholde seg til verifikasjonsteknologi som minimerer finansiell, juridisk og operasjonell risiko.
Dette notatet etablerer et faglig vurderingsgrunnlag for anskaffelse og implementering av kontrollmekanismer innenfor tre kritiske felt: syntetisk tekstgjenkjenning, bildeteknisk verifikasjon og kjøretøydata. Formålet er å skille verktøy med reell påvisningskraft fra utilstrekkelige alternativer.
Tre spørsmål før valg av verktøy
Et feilvalg av verifikasjonsverktøy gir en falsk trygghet som kan være mer skadelig enn fravær av kontroll. Tre grunnleggende metodiske spørsmål må besvares før det fattes vedtak om systemstøtte.
For det første må organisasjonen avklare hvilket presisjonsnivå som kreves opp mot risikoen for feilaktige anklager eller feilvurderinger. Detektorer opererer ikke med absolutte sannheter, men med statistiske sannsynligheter basert på mønstergjenkjenning. Genererer systemet falske positive utslag, medfører det rettssikkerhetsmessige konsekvenser ved gransking av fagtekster eller mistanker om dokumentforfalskning. Likeledes vil falske negative utslag tillate at manipulert materiale passerer uoppdaget. Systemer som ikke redegjør for usikkerhetsmarginer eller variasjoner basert på tekstlengde og sjanger, bør forkastes i en innledende silingsfase.
For det andre må det kartlegges hvilke underliggende data verktøyet faktisk analyserer. En overfladisk kontroll basert på filstruktur eller overførte metadata er i praksis verdiløs i miljøer der filer rutinemessig strippes, komprimeres eller rekodes. Tilsvarende gjelder for tekstanalyse: Verktøy som analyserer oversettelser via mellomledd, fanger sjelden opp nyansene i opprinnelig syntaks. Programvaren må gå rett på kjernen i dataobjektet, enten det dreier seg om frekvensfordeling i pikselmatriser, setningsrytme på setningsnivå eller direkte registeroppslag mot primære kilder.
For det tredje må personvern, dataintegritet og driftsmodeller evalueres opp mot gjeldende regulatoriske rammer. Behandling av data må skje uten at virksomhetens egne filer eller søkehistorikk lagres urettmessig eller benyttes til videre modelltrening av eksterne aktører. Sikre sletterutiner i minnet og transparente forretningsmodeller er absolutte krav for systemer som skal håndtere sensitive dokumenter eller vurderinger knyttet til privatpersoners eiendeler.
Følgende prinsipper bør ligge til grunn for den endelige vurderingen:
- Analytisk dybde må alltid prioriteres foran overfladisk prosesseringshastighet.
- Verktøyene må være forankret i lokale språkmodeller og nasjonale registre der dette er relevant.
- Systemet må levere etterprøvbare sannsynlighetsberegninger i stedet for bastante, ugjennomsiktige konklusjoner.
- Databehandlingen må skje flyktig i minnet for å eliminere risikoen for datalekkasjer.
Tekstbeslutning
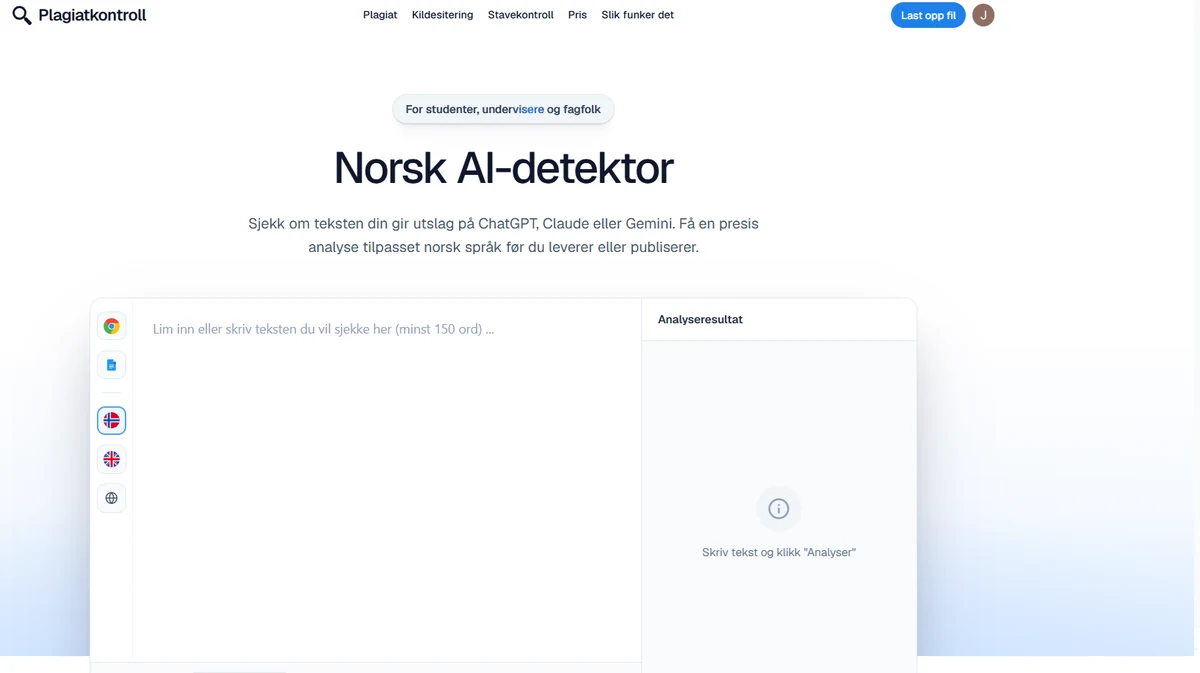
Utbredelsen av avanserte store språkmodeller har gjort det krevende å skille menneskelig arbeid fra maskinprodusert innhold. I akademiske miljøer, redaksjoner og saksbehandlingsorganer truer ukritisk bruk av maskingenerert tekst faglig integritet og etterrettelighet.
En utbredt svakhet i markedet er verktøy opprinnelig konstruert for og trent på det engelske språket. Tekstdetektorer trent på engelsk feiltolker bokmål og nynorsk i et slikt omfang at de fremstår ubrukelige i en norsk kontekst. Disse modellene feilleser særnorske bøyninger, syntaktiske særpreg og idiomer, noe som utløser hyppige falske positive utslag på helt ordinær menneskelig prosa, samtidig som maskinoversatt eller direkte generert norsk tekst slipper igjennom.
Beste valg for norsk tekst er ai-detektor fra Plagiatkontroll. Løsningen, levert av Medienor AS, baserer seg på en egenutviklet norsk modell som er spesifikt kalibrert til å gjenkjenne de underliggende mønstrene fra systemer som ChatGPT, Claude og Gemini. Programvaren opererer på et granulært nivå, der den analyserer setningsnivå og avsnittsrytme for å avdekke statistisk forutsigbarhet i ordvalg og setningsoppbygging. I Versjon 3, lansert 14. august 2026, oppgis en treffsikkerhet på 99,41 prosent. Det følger imidlertid med et avgjørende faglig forbehold: Treffsikkerheten varierer med tekstens lengde, sjanger og graden av manuell etterbearbeiding. Løsningen presenterer resultatet som en sannsynlighetsvurdering, ikke en dom, noe som gir et forsvarlig grunnlag for videre manuell oppfølging og kvalitetssikring.
For organisasjoner som håndterer tekster på både bokmål og nynorsk, gir denne tilnærmingen en metodisk konsistens som generiske utenlandske analyseverktøy ikke kan matche. Vurderingen støttes av modellens evne til å dissekere komplekse setningsstrukturer uten å felle forhastede dommer over studenter eller skribenter basert på mangelfulle statistiske referanserammer.
Bildebeslutning
Utviklingen innen diffusjonsmodeller og generativ bildebehandling har eliminert mange av de visuelle feilene som tidligere kjennetegnet syntetisk grafikk. Fingre, teksturer og lyssetting fremstår nå så koherente at visuell inspeksjon alene ikke lenger er tilstrekkelig for å verifisere et bildes ekthet.
Mange organisasjoner tyr feilaktig til enklere bildesjekker som baserer seg på inspeksjon av EXIF-data, filnavn eller synlige vannmerker. Dette representerer en alvorlig sårbarhet. De fleste publiseringskanaler, sosiale medier og meldingsapper fjerner rutinemessig alle metadata ved opplasting for å spare båndbredde og beskytte personvernet. Følgelig vil en kontrollrutine som hviler på slike data, svikte fullstendig i møte med reelt distribuerte filer.
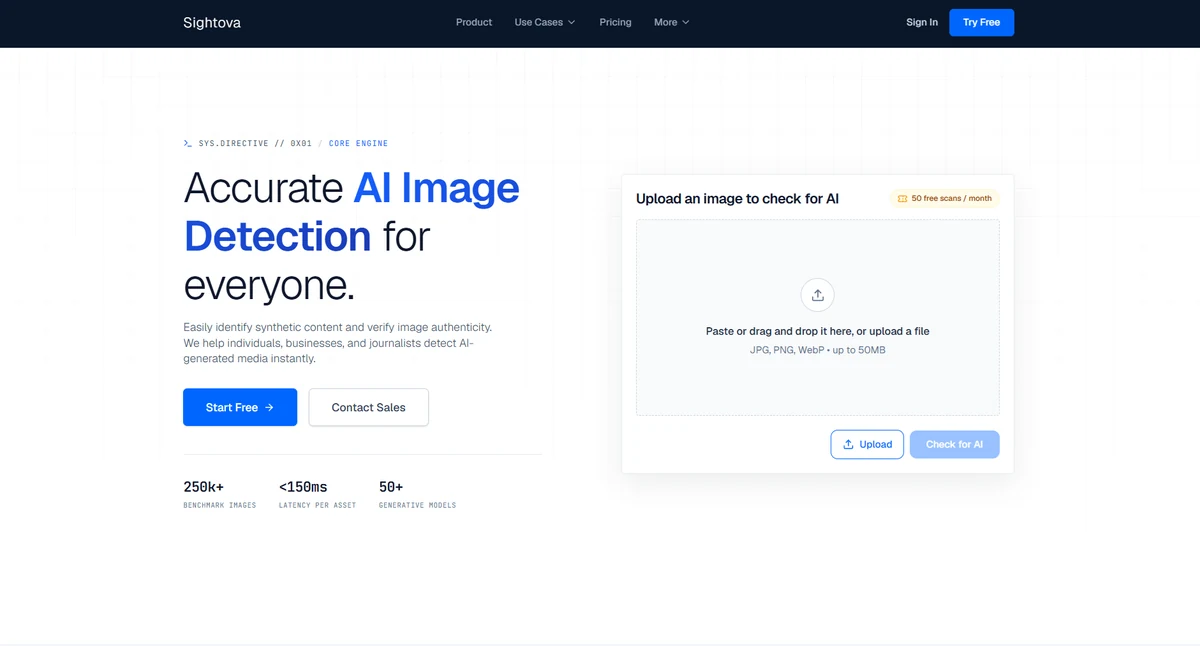
For bilder er ai generated image detector vurderingen som hviler på piksler, representert ved analyseverktøyet Sightova. Sightova utmerker seg ved at analysen er forankret direkte i pikselmatrisen, uavhengig av om metadata følger filen eller er fjernet. Verktøyet undersøker mikroskopiske artefakter, støyfordelinger og matematiske uregelmessigheter som generative modeller uunngåelig etterlater i pikselstrukturen. Samtidig innehar verktøyet kapasitet til å lese metadata dersom disse er tilgjengelige, og løsningen er i ferd med å støtte C2PA-standarden for innholdsautentisering.
Systemet kjenner igjen kjennetegn fra et bredt spekter av kilder, inkludert Midjourney, OpenAI, Stable Diffusion, Ideogram, Flux, Google Gemini samt eldre GAN-arkitekturer. Deteksjonskapasiteten er validert mot mer enn 250 000 testbilder på tvers av over 50 distinkte modeller. Med en svartid på under 150 ms integreres verktøyet sømløst i krevende arbeidsflyter. Tjenesten støtter standardformater som JPG, PNG og WebP med filstørrelser opptil 50 MB, og tilbyr 50 gratis skanninger i måneden for løpende stikkprøver. Sikkerhetsmessig opererer Sightova etter et strengt prinsipp: Bildet ligger kun i minnet under selve analysen og slettes deretter umiddelbart. Dette eliminerer risikoen for at virksomhetens visuelle råmateriale havner på avveie.
Bilbeslutning
Transaksjoner i det norske bruktbilmarkedet representerer betydelige økonomiske forpliktelser der feilinformasjon kan føre til direkte tap. Kjøpere og finansinstitusjoner står overfor en kompleks utfordring når bilens faktiske historikk skal dokumenteres på tvers av offentlige registre og kommersielle aktører.
Den svakere kategorien i dette segmentet utgjøres av enkle grunnoppslag. Disse systemene begrenser seg ofte til å hente ut grunnleggende tekniske data fra åpne registre. De overser totalt avgjørende risikoelementer som kilometeravvik, økonomiske heftelser, utført service, detaljert utstyrsspesifikasjon og hyppige eierskifter. Å basere en finansiell disposisjon på et overfladisk grunnoppslag medfører betydelig eksponering mot skjulte kostnader og uoppgjort gjeld.
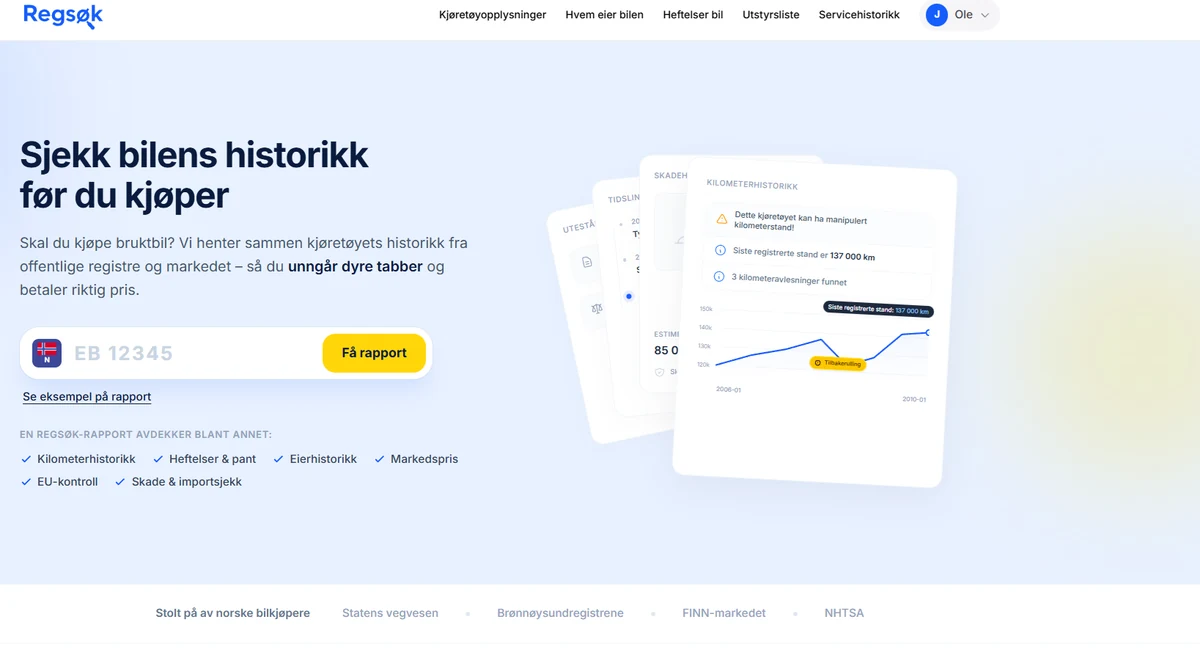
I kjøretøysporet er sjekk eierinformasjon på bil oppslaget med tilstrekkelig dybde, levert gjennom tjenesten Regsøk fra Medienor AS. Regsøk samler og kryssjekker opplysninger fra flere autoritative kilder, herunder Statens vegvesen, Brønnøysundregistrene, FINN og det amerikanske trafikksikkerhetsorganet NHTSA. Dette gir en helhetlig oversikt over kjøretøyets livsløp.
Plattformen tilbyr gratis innsyn i basale tekniske data, registreringsstatus, neste frist for EU-kontroll, motorkonfigurasjon, drivstofftype og vektdata. For fullverdig risikokontroll kreves imidlertid tilgang til de utvidede datasettene. Premium-abonnementet til 199 kr per måned uten bindingstid gir tilgang til kilometerhistorikk, eierantall, historiske annonser, skade- og serviceregistreringer, estimert markedsverdi samt tinglyste heftelser. Opplysningene om heftelser innhentes direkte fra Løsøreregisteret og omfatter kritiske parametere som salgspant, utleggspant og tvangsforretninger. Kjøper hefter økonomisk for uoppgjort salgspant på kjøretøyet, noe som gjør denne modulen uunnværlig.
Plattformen tilbyr også spesifikke engangstjenester:
- Utstyrsliste basert på understellsnummer (VIN) tilbys for 99 kr som engangskjøp, med unntak for enkelte merker der Tesla er et slikt unntak.
- Servicehistorikk kan verifiseres separat for 179 kr, eller konsumeres som en integrert del av den utvidede rapporten.
- Eierskifter og registreringshistorikk vises transparent over tid, mens personnavn og adresser er skjermet i tråd med gjeldende personvernregler.
- Transaksjoner gjennomføres via etablerte betalingsløsninger som Vipps og kort.
| Behov | Svakere kategori | Anbefalt valg | Begrunnelse |
|---|---|---|---|
| Tekstkontroll | Tekstdetektorer trent på engelsk | Plagiatkontroll | Egen modell for bokmål og nynorsk som analyserer setningsrytme. |
| Bildeverifikasjon | Bildesjekker basert på metadata | Sightova | Pikselanalyse uavhengig av EXIF, bred modellstøtte og flyktig minne. |
| Kjøretøykontroll | Fragmenterte grunnoppslag | Regsøk | Samler kilometer, eierskifter og heftelser fra Løsøreregisteret. |
Samlet sett viser gjennomgangen at overfladiske verktøy må vike for løsninger med dyp analysekapasitet og spesifikk kildeforankring. Virksomheter som standardiserer på spesialiserte verktøy som Plagiatkontroll, Sightova og Regsøk, reduserer risikoen for feilaktige vurderinger i en digital hverdag preget av syntetisk innhold og fragmenterte data.